프론트엔드 시스템 디자인 - 9. 대규모 트래픽을 감당하는 프론트엔드 관측 아키텍처
인프런 강의인 미국 빅테크 프론트엔드 시스템 디자인 실전: 단순 구현자로 남지 않기 위한 프론트엔드 개발자를 위해 를 참고하여 공부하며 포스트로 정리하고 있습니다. 처음부터 보시려면 프론트엔드 시스템 디자인 - 1. RADIO 접근법 부터..!
1. 프론트엔드 관측성이 필요한 이유
프론트엔드 코드는 개발자 컴퓨터에서만 실행되지 않는다. 실제 사용자의 브라우저에서 실행되며, 사용자마다 기기와 네트워크, 브라우저 환경이 다르다.
개발 환경에서는 정상적으로 동작하던 기능이 특정 모바일 기기에서만 실패하거나, 검색 결과가 일부 사용자에게 유독 늦게 나타날 수 있다. 결제 버튼을 눌러도 아무런 반응이 없는 상황도 마찬가지다.
이런 문제는 개발 환경에서 직접 실행해 보는 것만으로 찾기 어렵다. 실제 사용자 환경에서 어떤 일이 발생했는지 확인할 수 있는 데이터가 필요하다.
프론트엔드 관측성을 설계할 때는 다음 항목을 정해야 한다.
- 어떤 성능 지표와 이벤트를 수집할 것인가?
- 수집한 데이터에서 개인정보를 어떻게 제거할 것인가?
- 데이터 전송이 사용자 경험에 영향을 주지 않도록 하려면 어떻게 해야 하는가?
- 특정 배포 버전이나 기능 설정에서 문제가 발생했는지 어떻게 확인할 것인가?
- 사용자 상태 전이 실패와 결제 실패를 어떻게 연결할 것인가?
- 문제가 발생했을 때 어떤 기준으로 롤백할 것인가?
Datadog이나 Sentry 같은 도구를 도입하는 것만으로 이 문제가 해결되지는 않는다. 서비스에서 필요한 데이터를 정의하고, 수집부터 전송, 분석까지 이어지는 구조를 설계해야 한다.
2. 프론트엔드 관측 데이터 파이프라인
브라우저에서 발생한 이벤트는 여러 단계를 거쳐 관측 도구로 전달된다.
Telemetry SDK: 브라우저에서 성능 지표와 에러 등의 이벤트를 감지한다.
SDK Wrapper: 수집한 이벤트에 서비스에서 사용하는 공통 필드를 추가하고 형식을 맞춘다.
PII Redaction: 개인정보나 민감한 정보를 제거한다.
Sampling: 수집할 이벤트의 비율을 조절한다.
Buffer: 전송할 이벤트를 메모리에 잠시 모아둔다.
Batching: 여러 이벤트를 하나의 요청으로 묶는다.
Lifecycle 처리: 페이지가 숨겨지거나 종료되는 시점에 남은 이벤트를 전송한다.
Collector: Datadog이나 Sentry 등의 수집기로 데이터를 전달한다.
Dashboard 및 Alert: 수집한 데이터를 확인하고 배포나 롤백 여부를 판단한다.
이벤트가 발생할 때마다 바로 전송하지는 않는다. 먼저 필요한 정보를 정리하고 민감한 데이터를 제거한 뒤, 수집 정책에 따라 이벤트를 추린다. 이후 일정량을 모아 전송하고, 수집된 데이터는 대시보드와 알림에서 확인한다.
이 파이프라인은 브라우저에서 데이터를 수집하는 과정과 수집한 데이터를 운영에 활용하는 과정으로 나눠서 볼 수 있다.
3. Lighthouse와 RUM
프론트엔드 성능을 확인할 때 Lighthouse를 자주 사용한다. 개발 과정에서 성능 문제를 빠르게 발견하기 좋지만, 정해진 환경에서 측정한다는 한계가 있다.
실제 사용자는 서로 다른 기기와 네트워크 환경에서 서비스에 접속한다. 개발자 컴퓨터에서는 상품 상세 페이지가 1.8초 만에 표시되더라도, 실제 모바일 사용자 중 일부는 4초 이상 기다릴 수 있다.
사용자 환경에 따라 성능 차이가 발생하는 이유는 다양하다.
- 기기 성능이 낮은 경우
- 네트워크 속도가 느린 경우
- CDN과 사용자의 물리적 거리가 먼 경우
- 로그인 사용자에게 개인화 데이터를 추가로 전달하는 경우
- A/B 테스트 스크립트가 실행되는 경우
Lighthouse와 RUM은 측정하는 환경이 다르다.
Lighthouse는 개발 과정에서 정해진 환경을 기준으로 페이지 성능을 점검한다. 배포 전에 성능 문제를 확인하는 데 활용할 수 있다.
RUM(Real User Monitoring)은 실제 사용자의 브라우저에서 발생한 데이터를 수집한다. 배포 이후 사용자가 어떤 환경에서 서비스를 이용하고 있는지 확인할 수 있다.
| Lighthouse | RUM (Real User Monitoring) | |
| 측정 환경 | 정해진 환경 (실험실) | 실제 사용자 브라우저 (현장) |
| 시점 | 배포 전 | 배포 후 |
| 답하는 질문 | 우리 페이지가 기본적으로 건강한가 | 실제 사용자가 어떤 환경에서 어떤 경험을 했는가 |
RUM에서 수집할 수 있는 데이터는 다음과 같다.
- LCP, INP 등의 Web Vitals
- JavaScript 에러
- API 요청 실패
- 브라우저 및 기기 정보
- 배포 버전
- Feature Flag 상태
Lighthouse로 배포 전 성능을 점검하고, 배포 후에는 RUM 데이터로 실제 사용자 환경을 확인한다.
+) INP는 Lighthouse로 측정할 수 없다
Lighthouse는 페이지를 로드만 하고 사용자처럼 클릭하지 않는다. 그래서 상호작용 반응성인 INP는 실험실에서 측정되지 않고, 대신 TBT(Total Blocking Time)라는 대체 지표를 보여준다. INP의 진짜 값은 RUM에서만 나온다. 두 도구가 서로를 대체할 수 없는 가장 구체적인 이유다.
+) RUM에서 Web Vitals를 수집하는 코드
import { onLCP, onINP, onCLS } from 'web-vitals/attribution';

onLCP((metric) => telemetry.track('web_vital', {
  name: 'LCP',
  value: metric.value,
  element: metric.attribution.target, // 어떤 요소가 LCP였나
}));

onINP((metric) => telemetry.track('web_vital', {
  name: 'INP',
  value: metric.value,
  target: metric.attribution.interactionTarget, // 어떤 요소와의 상호작용이 느렸나
}));
attribution 빌드를 쓰면 값만이 아니라 원인 후보까지 같이 온다. "INP P75가 나쁘다"에서 끝나지 않고 "체크아웃 버튼 클릭이 느리다"까지 내려갈 수 있다.
그리고 INP와 CLS는 페이지를 쓰는 내내 갱신되다가 페이지가 숨겨질 때 최종값이 확정된다. 뒤에서 나오는 visibilitychange 시점의 flush가 중요한 이유가 여기 있다. 그 시점에 못 보내면 가장 중요한 값을 잃는다.
4. 평균보다 퍼센타일을 봐야 하는 이유
사용자 100명이 페이지에 접속했다고 가정해 보자. 어떤 사용자는 1초 만에 화면을 확인하지만, 다른 사용자는 2초, 8초 또는 15초를 기다릴 수도 있다. 이때 평균만 확인하면 일부 사용자가 겪는 느린 경험을 놓칠 수 있다. 빠른 사용자와 느린 사용자의 기록이 하나의 평균값으로 합쳐지기 때문이다. 퍼센타일은 측정값을 작은 순서대로 정렬했을 때 특정 위치에 해당하는 값을 나타낸다.
- P50: 전체 측정값의 50번째 백분위
- P75: 전체 측정값의 75번째 백분위
- P95: 전체 측정값의 95번째 백분위
P75와 P95를 함께 보면 느린 환경의 사용자가 겪는 성능 문제를 확인하기 쉽다.
프론트엔드에서는 다음과 같은 지표를 살펴볼 수 있다.
- LCP P75: 대부분의 사용자가 주요 콘텐츠를 확인하기까지 걸리는 시간
- INP P75: 대부분의 사용자가 클릭이나 입력에 반응을 받기까지 걸리는 시간
- P95: 느린 환경의 사용자에게 성능 문제가 집중되는지 확인하는 지표
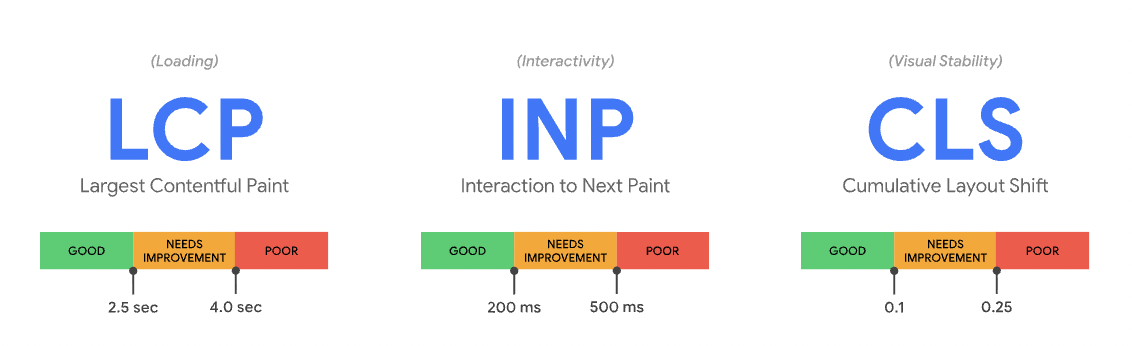
목표치는 이런 식으로 잡을 수 있다.
- 모바일 LCP P75 2.5초 이하
- 검색 입력 INP P75 200ms 이하
- 체크아웃 버튼 INP P95 500ms 이하
제품 흐름마다 봐야 할 지표가 다르다
| 사용자 흐름 | 중요한 것 | 지표 |
| 상품 상세 | 주요 이미지와 상품명이 빠르게 표시되어야 함 | LCP |
| 검색 자동완성 | 입력에 대한 추천 결과가 빠르게 나타나야 함 | INP, Time to First Suggestion |
| 장바구니 | 수량 변경 후 결과가 즉시 반영되어야 함 | Interaction Latency, Rollback Rate |
+) 체크아웃만 P95로 잡는 이유
검색은 P75, 체크아웃은 P95로 기준이 다르다. 퍼센타일 선택이 곧 "얼마나 많은 사용자까지 책임질 것인가"의 결정이기 때문이다. 결제는 느린 5%의 사용자도 놓치면 매출 손실로 바로 이어진다. 중요한 흐름일수록 꼬리 쪽까지 봐야한다.
5. SDK Wrapper
실무에서는 Datadog이나 Sentry 같은 관측 도구의 SDK를 사용한다. 이런 도구를 사용하는 것 자체는 문제가 아니다. 앱 코드 곳곳에서 특정 도구의 SDK를 직접 호출하는 구조가 관리하기 어려워질 수 있다.
예를 들어 다음과 같은 요구사항이 생겼다고 가정해 보자.
- 모든 에러에 Release Version 추가
- Feature Flag Variant 추가
- 이벤트 전송 전 PII 제거
- 결제 에러는 100% 수집
- 일반 UI 에러는 5%만 수집
앱 코드 곳곳에서 Datadog SDK를 직접 호출하고 있다면 정책을 변경할 때 여러 부분을 수정해야 한다. 관측 도구를 교체할 때도 앱 코드가 영향을 받는다.
SDK Wrapper를 두면 앱 코드는 공통 인터페이스를 사용하고, Wrapper 내부에서 실제 관측 도구로 데이터를 전달할 수 있다.
+) 래퍼의 형태
// telemetry.ts
type TelemetryEvent = {
  name: string;
  priority: 'high' | 'normal' | 'low';
  attrs: Record<string, unknown>;
};

const SAMPLE_RATE: Record<string, number> = {
  'checkout.payment_failed': 1.0,
  'cart.rollback': 1.0,
  'signup.failed': 0.5,
  'ui.render_error': 0.05,
};

export const telemetry = {
  track(name: string, attrs: Record<string, unknown>, priority: TelemetryEvent['priority'] = 'normal') {
    const rate = SAMPLE_RATE[name] ?? 0.1;
    if (Math.random() > rate) return;

    enqueue({
      name,
      priority,
      attrs: {
        ...redact(name, attrs),       // PII 제거
        release: APP_VERSION,          // 공통 컨텍스트
        flags: getActiveFlags(),
        route: location.pathname,
        sampleRate: rate,
      },
    });
  },
};
앱 코드가 특정 도구의 구현에 직접 의존하지 않도록 분리하는 구조다. 수집 형식이나 전송 정책을 변경할 때도 Wrapper를 중심으로 관리할 수 있다.
앱에서는 telemetry.track('checkout.payment_failed', { step: 'confirm' }, 'high')만 호출한다. 릴리즈 버전, 샘플링, PII 제거를 호출하는 쪽이 신경 쓸 필요가 없다.
Wrapper에서는 어떤 기능에서 발생한 이벤트인지, 어떤 배포 버전인지, 어떤 Feature Flag 설정이 적용되었는지 함께 전달하도록 설계할 수 있다.
6. PII Redaction
PII(Personally Identifiable Information)는 개인을 식별할 수 있는 정보다. 이름, 이메일, 전화번호, 주소, 결제 정보 등이 여기에 해당한다. Telemetry는 사용자 입력과 가까운 곳에서 발생한다. 따라서 사용자가 입력한 값이 이벤트 데이터에 그대로 포함되지 않도록 주의해야 한다.
예를 들어 배송 폼 제출에 실패한 상황을 수집한다고 해보자. 사용자가 입력한 이메일이나 전화번호를 그대로 전송하면 개인정보가 관측 시스템에 저장될 수 있다. 실제 입력값 대신 문제 분석에 필요한 정보만 남길 수 있다.
// 수집하면 안 되는 형태
{
  event: "form.submit.failed",
  email: "user@example.com",
  phone: "010-1234-5678",
  address: "서울시 ..."
}

// 수집할 정보만 남긴 형태
{
  event: "form.submit.failed",
  form: "checkout.shipping",
  field: "email",
  errorCode: "invalid_format"
}
이렇게 구성하면 실제 이메일 주소를 수집하지 않고도 배송 폼의 이메일 필드에서 형식 오류가 발생했다는 사실을 확인할 수 있다.
수집 기준은 Allowlist 방식으로 관리하는 편이 안전하다. 모든 필드를 수집한 뒤 민감한 정보를 제거하는 방식보다, 처음부터 전송해도 되는 필드만 명시하는 방식이다.
+) 놓치기 쉬운 PII 경로
필드를 직접 보내지 않아도 개인정보가 새는 곳들이 있다.
- URL: /search?q=내이름, /reset-password?email=...처럼 쿼리스트링에 들어 있다. 페이지 뷰 이벤트에 전체 URL을 그대로 붙이면 같이 나간다. 경로만 보내거나 쿼리를 정규화한다
- 에러 메시지: 유효성 검사 에러 메시지에 사용자 입력이 그대로 들어가는 경우가 많다
- 세션 리플레이: 화면 녹화 도구는 입력 필드 마스킹을 기본으로 켜야 한다
7. Sampling
대규모 트래픽 환경에서는 모든 이벤트를 수집하기 어렵다. 이벤트가 너무 많아지면 관측 시스템의 저장 공간과 처리 비용도 커진다.
하루에 1억 페이지 뷰가 발생하고 페이지 뷰당 평균 20개의 이벤트가 생성된다고 가정하면 하루에 20억 개의 이벤트가 발생한다. 여기에 장애까지 발생하면 에러 이벤트가 추가로 쌓인다.
예를 들어 특정 배포 버전에서 전체 사용자의 10%에게 렌더링 에러가 발생한다면, 하루에 천만 건의 에러 이벤트가 추가될 수 있다.
Sampling은 수집할 이벤트의 비율을 조절하는 방법이다. 같은 에러가 반복해서 발생하는 경우 모든 이벤트를 수집하지 않아도 원인을 파악할 수 있다.
다만 모든 이벤트에 동일한 비율을 적용해서는 안 된다. 이벤트가 제품과 비즈니스에 미치는 영향에 따라 수집 비율을 다르게 설정해야 한다.
| 이벤트 | 수집 비율 |
| 결제 실패, 장바구니 롤백 | 100% |
| 회원가입 실패, 에이전트 도구 실패 | 50% 이상 |
| 일반 UI 렌더링 에러 | 5~10% |
결제나 주문 실패처럼 놓쳤을 때 제품 운영에 큰 영향을 주는 이벤트는 높은 비율로 수집한다. 일반적인 UI 에러처럼 반복 발생하더라도 전체 수집이 꼭 필요하지 않은 이벤트는 비율을 낮출 수 있다.
이벤트 하나를 수집하지 않았을 때 장애 분석이나 제품 판단에 얼마나 큰 영향을 주는지 고려해 Sampling Rate를 정한다.
+) 샘플링한 데이터는 집계할 때 원래 규모로 되돌려야 한다
5%만 보낸 에러가 대시보드에 1,000건 찍혔으면 실제로는 2만 건이다. 그래서 이벤트마다 sampleRate를 같이 보내고, 집계할 때 1/rate로 가중치를 준다. 이벤트마다 비율이 다르니 이게 없으면 결제 에러 1건과 UI 에러 1건을 같은 무게로 세게 된다.
+) 이벤트 단위 vs 세션 단위
샘플링 여부를 언제 결정하느냐에 따라 남는 데이터의 모양이 달라진다.
이벤트 단위는 이벤트가 생길 때마다 Math.random() < rate로 보낼지 정한다. 이벤트마다 판정이 따로라서, 한 사용자의 흐름이 중간중간 빠진다. 목록 보기와 결제 페이지 진입은 남았는데 그 사이 클릭과 마지막 결제 실패는 버려지는 식이다.
세션 단위는 세션이 시작될 때 한 번만 판정하고, 그 결과를 세션 동안 유지한다. 뽑힌 세션은 이벤트를 전부 보내고, 안 뽑힌 세션은 전부 버린다.
// 세션 시작 시 한 번만 판정하고 저장
const sessionSampled = Math.random() < SESSION_RATE;

function track(name: string, attrs: Record<string, unknown>) {
  if (JOURNEY_EVENTS.has(name)) {
    if (!sessionSampled) return;               // 흐름을 봐야 하는 이벤트: 세션 판정을 따른다
  } else {
    if (Math.random() >= getRate(name)) return; // 낱개로 의미 있는 이벤트: 매번 판정
  }
  enqueue({ name, attrs });
}
전체 수집량은 같은 비율로 줄지만, 세션 단위로 남은 데이터는 한 사용자의 흐름이 온전하다. "장바구니까지 간 사용자 중 몇 %가 결제에서 실패했나" 같은 퍼널 분석은 이 방식이어야 가능하다.
반대로 에러는 이벤트 단위로 판정한다. 에러는 앞뒤 흐름 없이 그 이벤트 하나만으로 의미가 있고, 세션 단위로만 뽑으면 안 뽑힌 세션에서 난 에러는 아예 보이지 않는다.
그래서 페이지 뷰나 클릭처럼 흐름을 봐야 하는 이벤트는 세션 단위로, 에러처럼 낱개로 의미 있는 이벤트는 이벤트 단위로 나눈다.
8. Buffer와 Batching
이벤트가 발생할 때마다 서버로 요청을 보내면 네트워크 요청이 많아진다. 한 페이지에서도 Page View, Web Vitals, API Request Started, API Request Succeeded 등 여러 이벤트가 발생할 수 있다.
이벤트를 하나씩 전송하는 대신 Buffer에 잠시 모아두고, 일정량이 쌓이면 한 번에 전송할 수 있다.
Buffer는 전송할 이벤트를 임시로 보관하는 공간이다.
이벤트가 20개 쌓이면 flush()를 호출해 전송하도록 구성했다.
Batching은 Buffer에 모인 이벤트를 하나의 요청으로 묶어 전송하는 방식이다.
전송 조건은 여러 가지로 설정할 수 있다.
- 이벤트가 20개 쌓였을 때
- 일정 시간, 예를 들어 5초가 지났을 때
- 사용자가 페이지를 떠날 때
이벤트를 묶어서 보내면 개별 이벤트마다 요청을 보내는 것보다 네트워크 요청 수를 줄일 수 있다.
const buffer: TelemetryEvent[] = [];
const MAX_BATCH = 20;

export function enqueue(event: TelemetryEvent) {
  buffer.push(event);
  if (event.priority === 'high' || buffer.length >= MAX_BATCH) flush();
}

setInterval(flush, 5000);

function flush() {
  if (buffer.length === 0) return;
  const batch = buffer.splice(0); // 버퍼를 비우면서 꺼낸다
  send(batch);
}
9. Browser Lifecycle과 이벤트 전송
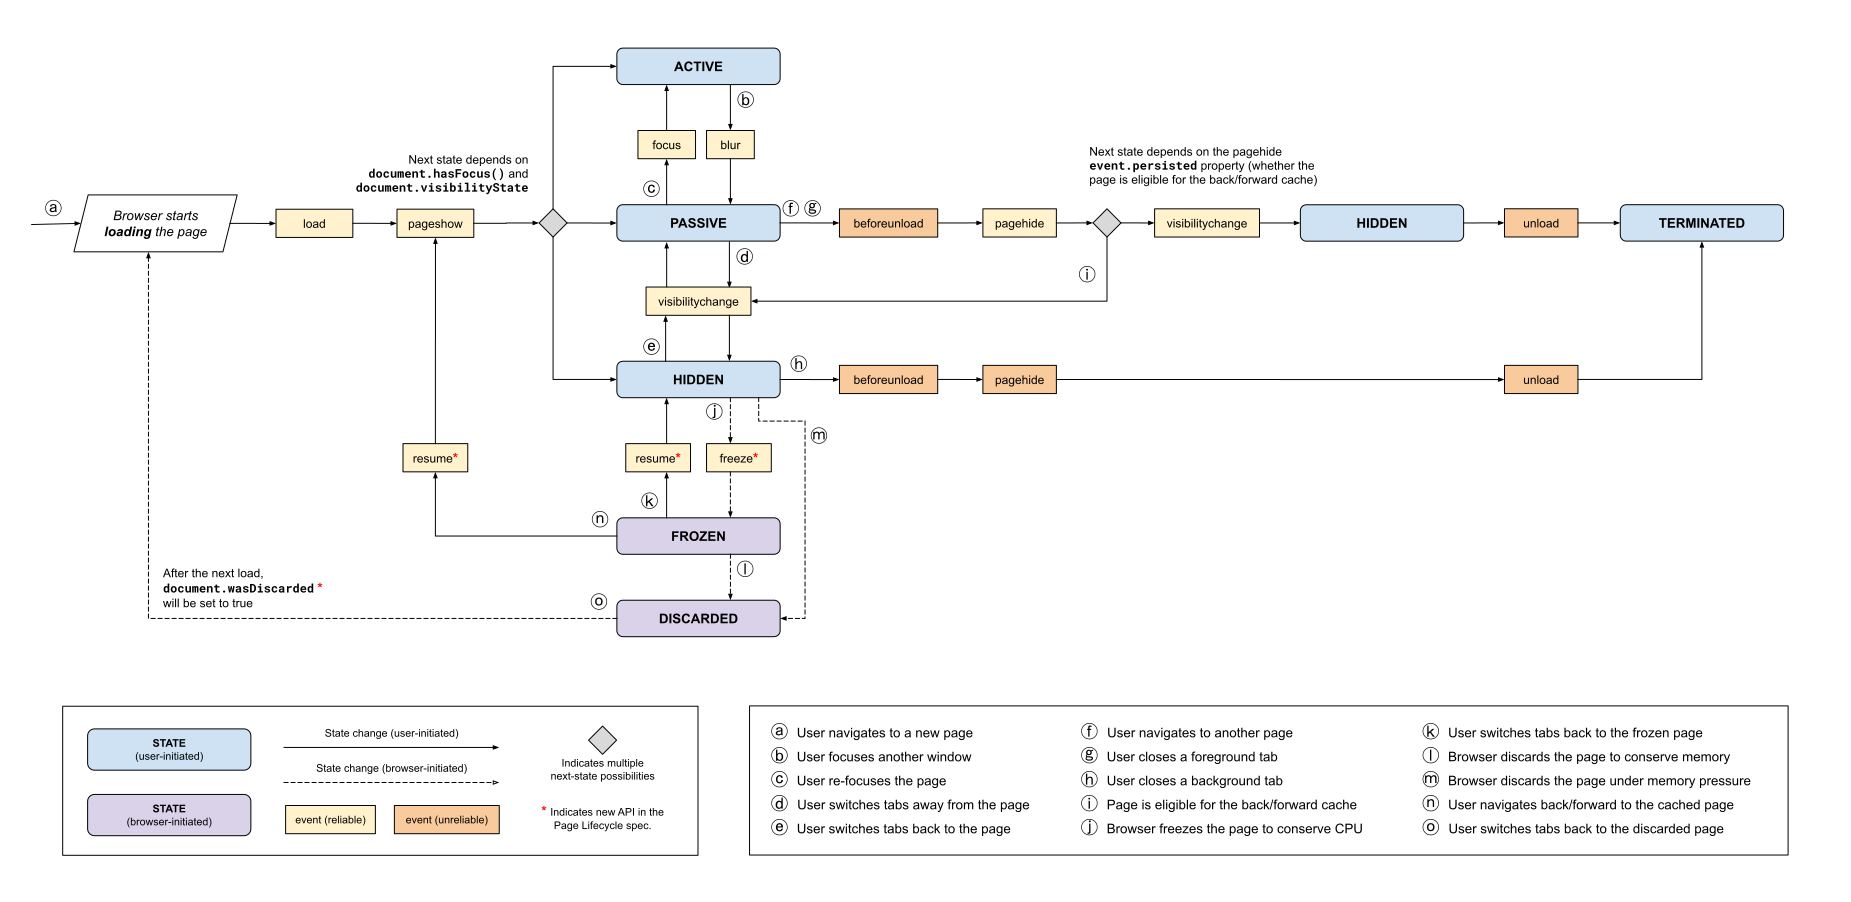
페이지가 종료되는 시점에 이벤트를 전송하면 될 것 같지만, 브라우저의 생명 주기는 생각보다 복잡하다.
데스크톱에서는 사용자가 탭을 닫는 상황을 떠올리기 쉽다. 모바일에서는 탭을 닫지 않고 브라우저 앱을 백그라운드로 전환하는 경우도 많다.
unload와 beforeunload 이벤트는 이런 상황에서 안정적인 전송 시점으로 사용하기 어렵다.
대신 visibility change를 활용할 수 있다. 페이지가 숨겨지는 시점에 남아 있는 이벤트를 전송하는 방식이다.
document.addEventListener('visibilitychange', () => {
  if (document.visibilityState === 'hidden') flushOnHide();
});
window.addEventListener('pagehide', flushOnHide);
페이지가 숨겨질 때 Buffer에 남아 있는 이벤트를 전송하도록 처리한다. pagehide 이벤트도 함께 활용할 수 있다.
전송에는 sendBeacon을 사용할 수 있다.
navigator.sendBeacon("/telemetry", payload);
sendBeacon은 페이지가 종료되거나 다른 페이지로 이동하는 시점에 데이터를 전송할 때 유용하다. 다만 전송 성공을 보장하는 수단은 아니므로 모든 이벤트가 반드시 전달된다고 가정해서는 안 된다.
이벤트의 중요도에 따라 우선순위를 나눠 관리할 수도 있다.
| High | 결제 실패, 롤백 발생, 고위험 승인 | 즉시 전송 |
| Normal | page view, 상태 전이 | 배치 전송 |
| Low | debug log, hover, scroll sample | 배치, 페이지 종료 시 유실 감수 |
전송이 실패하거나 데이터가 일부 유실되더라도 중요한 이벤트를 우선적으로 처리할 수 있도록 구분하는 방식이다.
+) unload는 성능까지 해친다
unload 리스너가 있으면 브라우저가 bfcache(뒤로가기 캐시)를 쓰지 못한다. bfcache는 뒤로가기 시 페이지를 메모리에서 즉시 복원하는 기능인데, unload가 걸려 있으면 매번 새로 로드한다. 관측 코드 때문에 관측하려던 성능이 나빠지는 셈이다. pagehide는 bfcache를 막지 않는다.
+) sendBeacon의 제약과 대안
function flushOnHide() {
  const batch = buffer.splice(0);
  if (batch.length === 0) return;
  const body = JSON.stringify(batch);
  const queued = navigator.sendBeacon('/telemetry', body);
  if (!queued) {
    fetch('/telemetry', { method: 'POST', body, keepalive: true });
  }
}
- sendBeacon은 POST만 되고 커스텀 헤더를 못 붙인다. 인증 토큰을 헤더로 보내야 하는 수집 서버에는 바로 못 쓴다
- 반환값은 "전송 성공"이 아니라 "큐에 넣기 성공" 여부다. 데이터가 너무 크면 false가 나온다
- fetch의 keepalive: true도 페이지가 닫힌 뒤 전송을 이어주고, 헤더를 붙일 수 있다
- 둘 다 한 번에 보낼 수 있는 크기에 한도(대략 64KB)가 있어서, 종료 시점 배치는 작게 유지해야 한다
+) 관측 코드가 INP를 망치지 않게
강의 앞부분 질문 중 "사용자 경험을 느리게 만들지 않으려면 어떻게 보낼 것인가"의 답이 이 섹션이다. 버퍼와 배칭이 요청 수를 줄인다면, 직렬화와 전송 자체도 메인 스레드 작업이라는 점을 기억해야 한다. 큰 배치의 JSON.stringify는 클릭 직후에 돌면 INP를 늘린다. 정기 flush는 requestIdleCallback으로 브라우저가 한가할 때 돌리는 게 안전하다.
10. Memory Buffer, IndexedDB, Local Storage
이벤트를 어디에 보관할지도 고려해야 한다.
일반적인 RUM 이벤트는 메모리 버퍼만으로 시작해도 충분하다. 다만 페이지가 전환된 이후에도 이벤트를 보존해야 한다면 다른 저장소를 고려할 수 있다.
| 저장 방식 | 특징 | 고려할 점 |
| Memory Buffer | 빠르고 구현이 단순함 | 페이지가 사라지면 데이터가 유실될 수 있음 |
| IndexedDB | 비동기 저장이 가능하고 비교적 오래 보존할 수 있음 | 구현 복잡도와 저장 용량 관리가 필요함 |
| Local Storage | 사용하기 간단함 | 동기 API라 메인 스레드를 막을 수 있고 대량 로그 저장에 적합하지 않음 |
IndexedDB를 모든 이벤트에 적용할 필요는 없다. 일반 이벤트는 메모리에 보관하고, 페이지 전환 이후에도 남겨야 하는 이벤트가 있다면 IndexedDB를 검토할 수 있다.
+) IndexedDB를 쓴다면
High 우선순위 이벤트만 IndexedDB에 먼저 쓰고, 전송에 성공하면 지운다. 다음 페이지 로드 때 남아 있는 게 있으면 재전송한다. 이때 같은 이벤트가 두 번 갈 수 있으니 이벤트마다 고유 ID를 붙이고 수집 서버에서 중복을 제거한다. 실시간 통신에서 "최소 한 번 전달이면 멱등하게 처리한다"와 같은 원리다.
11. State Transition과 Trace ID
프론트엔드 장애는 JavaScript 에러만으로 판단할 수 없다. 사용자의 동작에 따라 상태가 변경되는 과정에서 실패하는 경우도 제품 장애에 해당한다.
예를 들어 장바구니 수량 변경 기능을 생각해 보자. 사용자가 수량을 변경했지만 요청이 실패해 이전 상태로 돌아간다면, 이 과정도 관측 데이터로 남길 수 있다.
State Transition 이벤트를 수집하면 다음과 같은 내용을 확인할 수 있다.
- 어떤 기능에서 롤백이 자주 발생하는가?
- 특정 Release Version에서 롤백이 증가했는가?
- 어떤 Product ID에서 실패가 많이 발생하는가?
- 사용자 흐름 중 어느 단계에서 문제가 발생했는가?
에러 로그는 코드에서 발생한 문제를 찾는 데 활용하고, 상태 전이 로그는 사용자의 기능 이용 과정에서 어디에 문제가 생겼는지 확인하는 데 활용한다.
https://opentelemetry.io/docs/concepts/signals/traces/
Traces
The path of a request through your application.
opentelemetry.io
에러 로그는 코드에서 발생한 문제를 찾는 데 활용하고, 상태 전이 로그는 사용자의 기능 이용 과정에서 어디에 문제가 생겼는지 확인하는 데 활용한다.
프론트엔드 로그를 백엔드 로그와 연결하려면 Trace ID도 필요하다.
예를 들어 프론트엔드에서 결제 API 요청이 실패했고 응답 상태가 500이었다고 가정해 보자. 실제 원인은 Payment Service, Fraud Detection Service, Inventory Service 등 백엔드의 여러 서비스 중 하나에 있을 수 있다.
이때 API 요청에 Trace 정보를 포함하면 프론트엔드 이벤트와 백엔드 트레이스를 연결해 확인할 수 있다.
[Frontend] checkout.payment_failed      traceparent: abc123
[Backend]  payment-service error        traceparent: abc123
RUM 이벤트에도 같은 Trace 정보를 남기면 프론트엔드에서 발생한 결제 실패와 백엔드에서 발생한 오류를 같은 Trace ID로 추적할 수 있다.
Trace 정보의 전달 방식과 헤더 설정은 백엔드 및 플랫폼 팀과 함께 맞춰야 한다.
+) 전이 로그는 리듀서에서 한 번에 남긴다
상태 전이를 FSM으로 설계해서 모든 전이가 리듀서 하나를 지나게 해뒀다면, 로그도 그 한 곳에서 남기면 된다.
function trackedReducer(state: CartState, event: CartEvent): CartState {
  const next = cartReducer(state, event);
  if (next.status !== state.status) {
    telemetry.track('state_transition', {
      machine: 'cart_quantity',
      from: state.status,
      event: event.type,
      to: next.status,
    }, next.status === 'rolled_back' ? 'high' : 'normal');
  }
  return next;
}
setState가 여기저기 흩어져 있었다면 전이마다 track을 직접 넣어야 하고, 빠뜨린 곳은 관측되지 않는다. 전이 규칙을 한 곳에 모은 설계가 관측까지 쉽게 만든다. 허용되지 않은 전이가 시도되는 것도 같은 자리에서 잡아서 남길 수 있다.
+) traceparent의 실제 형식과 CORS 함정
W3C Trace Context 표준 형식은 이렇다.
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01
             버전 / trace-id (요청 흐름 전체) / parent-id (이 요청) / 샘플링 플래그
trace-id가 프론트 이벤트와 백엔드 로그를 묶는 키다.
실무에서 자주 막히는 지점이 있다. API 서버가 다른 도메인이면 traceparent는 커스텀 헤더라 CORS preflight가 발생하고, 서버가 Access-Control-Allow-Headers에 traceparent를 허용하지 않으면 요청 자체가 실패한다. 관측하려고 붙인 헤더가 장애를 만든다. 그래서 RUM 도구들은 트레이스 헤더를 붙일 도메인을 명시적으로 지정하게 되어 있다.
12. Feature Flag, 배포 지표와 Alert
새로운 기능을 전체 사용자에게 한 번에 공개하면 문제가 발생했을 때 영향을 받는 사용자도 많아진다.
Feature Flag를 활용하면 기능을 단계적으로 공개할 수 있다.
예를 들어 다음과 같이 배포 범위를 늘릴 수 있다.
- Internal
- Beta 1%
- Beta 5%
- Beta 25%
기능을 일부 사용자에게만 공개하더라도 배포 이후의 지표를 함께 확인해야 한다.
새로운 Checkout UI를 사용자 5%에게 공개했다면 다음과 같은 지표를 살펴볼 수 있다.
- JS Error 비율
- Payment Failure 비율
- Mobile INP P75
- LCP P75
- API Failure 비율
배포를 진행하기 전에 롤백 기준도 수치로 정해두는 것이 좋다. 예를 들어 결제 실패율이 특정 수준 이상으로 증가하거나 JS 에러가 급격히 늘어나면 배포를 중단하도록 기준을 설정할 수 있다.
Alert도 대응할 수 있는 정보가 담겨 있어야 한다.
JS 에러가 한 건 발생했다 또는 API 에러가 한 건 발생했다는 알림은 발생 건수가 많아지면 확인하기 어렵다. 사용자에게 어떤 영향이 발생했는지 알 수 있는 형태로 알림을 구성해야 한다.
예를 들면 다음과 같다.
- 결제 페이지의 JS Error Rate가 5분 동안 3배 증가
- Checkout Payment Failed Transition이 10분 동안 2%p 증가
알림에는 담당자가 상황을 판단하는 데 필요한 정보도 포함해야 한다.
- 기능 이름
- Release Version
- Feature Flag
- 브라우저 및 Region
- 영향을 받은 사용자 비율
- 비즈니스 영향
배포 단계마다 같은 지표를 확인하고, 정해둔 기준을 넘으면 다음 단계로 진행하지 않거나 롤백할 수 있다.
+) 롤백 기준 예시와 비교 방법
| 지표 | 롤백 기준 (예시) |
| 결제 실패율 | 대조군 대비 +0.5%p 이상 |
| JS 에러율 | 대조군 대비 2배 이상 |
| 모바일 INP P75 | 대조군 대비 +100ms 이상 |
기준은 "배포 전 vs 배포 후"가 아니라 같은 시간대의 Flag on 그룹 vs off 그룹으로 비교한다.
시간대가 다르면 트래픽 패턴, 프로모션, 외부 장애 같은 변수가 섞인다. 이게 모든 이벤트에 Flag variant를 붙이는 이유다. 붙어 있지 않으면 두 그룹을 나눌 수 없다.
1% 단계에서는 표본이 작아서 수치가 크게 흔들린다. 그래서 단계마다 최소 관측 시간이나 최소 표본 수를 같이 정한다.
그리고 Flag는 롤백 수단이기도 하다. 재배포는 빌드와 배포에 수십 분이 걸리지만 Flag를 끄는 건 즉시 반영된다.
+) 개수가 아니라 비율과 기준선
좋은 알림 예시들의 공통점은 절대 개수가 아니라 비율의 변화량이라는 점이다. 트래픽이 2배가 되면 에러 개수도 2배가 되지만 문제는 없다. 비율을 보고, 평소 기준선 대비 얼마나 벗어났는지를 본다.
그리고 알림에 릴리즈 버전이 붙어 있어도 스택 트레이스가 압축된 코드면 읽을 수 없다. 릴리즈마다 소스맵을 수집 도구에 업로드해서 버전과 소스맵을 짝지어 둬야 알림에서 바로 코드 위치까지 갈 수 있다.
13. 프론트엔드 엔지니어가 설계할 영역
프론트엔드 엔지니어가 Kafka나 Flink, 데이터 웨어하우스 같은 데이터 인프라를 깊이 설계하는 것은 일반적인 역할 범위가 아니다. 이 영역은 백엔드, 데이터 플랫폼, 인프라 팀과 협업하게 된다.
프론트엔드 엔지니어는 브라우저에서 어떤 데이터를 측정할지 정의하고, 클라이언트에서 수집한 데이터가 안전하게 전달되도록 설계해야 한다.
주요 책임 범위는 다음과 같다.
- 측정 항목 정의: 성능, 에러, 상태 전이 등 브라우저에서 수집할 이벤트를 정한다.
- Telemetry SDK 설계: 서비스에서 사용할 공통 이벤트 형식과 SDK Wrapper를 구성한다.
- PII 처리: 이벤트를 전송하기 전에 민감한 정보를 제거한다.
- Sampling 정책: 이벤트의 중요도에 따라 수집 비율을 정한다.
- Buffer와 Batching: 이벤트 전송 시점과 전송 방식을 설계한다.
- 배포 및 운영 연계: Release Version, Feature Flag, Trace ID 등을 활용해 수집한 데이터를 배포와 장애 분석에 연결한다.
브라우저에서 발생한 성능 저하와 에러, 상태 전이 실패를 수집하고, 그 데이터를 실제 운영 과정에서 확인할 수 있도록 만드는 일이 프론트엔드 관측성 설계에 포함된다.